Foundation Model là mô hình AI được huấn luyện trên dữ liệu rộng và có thể áp dụng hoặc điều chỉnh cho nhiều nhiệm vụ khác nhau. Đây là công nghệ có thể tái sử dụng phía sau một ứng dụng AI, không phải chatbot, sản phẩm cụ thể hay mức độ thông minh được bảo đảm.
Thuật ngữ này thường xuất hiện cùng Generative AI và Large Language Model (LLM). Ba khái niệm có liên quan nhưng mô tả các khía cạnh khác nhau: Foundation Model nói về phạm vi huấn luyện và khả năng tái sử dụng; Generative AI nói về năng lực tạo nội dung; còn LLM là Foundation Model tập trung vào ngôn ngữ.
Tóm tắt cốt lõi (Key Takeaways)
- Định nghĩa mô hình: Foundation Model được huấn luyện trên dữ liệu đa dạng để hỗ trợ nhiều nhiệm vụ phía sau.
- Huấn luyện và điều chỉnh: Mô hình học các mẫu tổng quát trong giai đoạn pretraining, rồi có thể được sử dụng trực tiếp hoặc điều chỉnh cho mục đích cụ thể.
- Đánh giá đầu ra: Nền tảng tái sử dụng có thể giúp phát triển AI nhanh hơn, nhưng đầu ra vẫn có thể sai, thiên lệch hoặc không phù hợp nếu không được đánh giá.
Foundation Model là gì?
Foundation Model là mô hình AI được huấn luyện trên lượng dữ liệu lớn và đa dạng, sau đó được dùng làm nền tảng cho nhiều ứng dụng và nhiệm vụ. Tùy dữ liệu và năng lực, mô hình có thể hỗ trợ viết, phân loại, phân tích hình ảnh, xử lý giọng nói hoặc trả lời câu hỏi. Google Cloud mô tả Foundation Model là các mô hình được huấn luyện trên lượng dữ liệu lớn và có thể được điều chỉnh cho nhiều nhiệm vụ khác nhau.
Từ foundation đề cập đến vai trò nền tảng có thể tái sử dụng. Doanh nghiệp không nhất thiết phải xây dựng một mô hình riêng cho từng nhiệm vụ. Họ có thể bắt đầu với mô hình được huấn luyện trên phạm vi rộng, rồi áp dụng vào một quy trình cụ thể hoặc điều chỉnh bằng dữ liệu bổ sung.
Có thể hình dung Foundation Model như nền móng của một tòa nhà nâng đỡ nhiều loại công trình. Tuy nhiên, phép so sánh này có giới hạn: Foundation Model không bảo đảm kết quả thành công. Mức độ hữu ích phụ thuộc vào dữ liệu, nhiệm vụ, chỉ dẫn, biện pháp bảo vệ và hoạt động đánh giá.
Ví dụ, doanh nghiệp có thể dùng một mô hình được huấn luyện rộng để tóm tắt báo cáo, phân loại tin nhắn khách hàng hoặc trích xuất thông tin từ tài liệu. Mô hình là năng lực nền tảng; công cụ rà soát tài liệu hoặc tính năng hỗ trợ khách hàng xây dựng quanh nó mới là ứng dụng.
Để hiểu rộng hơn về thuật ngữ AI Model, hãy xem AI Model là gì?.
Vì sao gọi là Foundation Model?
Foundation Model được gọi là mô hình nền tảng vì nó học các mẫu có thể tái sử dụng từ dữ liệu huấn luyện rộng trước khi được áp dụng cho một nhiệm vụ cụ thể. Cách tiếp cận này giảm nhu cầu xây dựng một hệ thống riêng, phạm vi hẹp cho từng trường hợp sử dụng. Sự chuyển dịch sang các mô hình linh hoạt, đa mục đích là ý tưởng cốt lõi của cách tiếp cận Foundation Model.
Quy trình thường gồm bốn bước:
1. Pretraining trên dữ liệu rộng: Mô hình được huấn luyện trên lượng dữ liệu lớn như văn bản, hình ảnh, âm thanh, video hoặc sự kết hợp của các loại dữ liệu này. Mô hình học các mẫu và mối quan hệ trong dữ liệu.
2. Năng lực có thể tái sử dụng: Mô hình tạo ra điểm khởi đầu cho nhiều nhiệm vụ, thay vì chỉ phục vụ một ví dụ hoặc ứng dụng duy nhất.
3. Sử dụng cho nhiệm vụ cụ thể: Nhà phát triển hoặc người dùng áp dụng mô hình vào công việc như tóm tắt báo cáo, nhận diện vật thể trong hình ảnh hoặc phân loại yêu cầu hỗ trợ.
4. Điều chỉnh thêm khi cần: Mô hình có thể nhận thêm chỉ dẫn, ngữ cảnh, ví dụ hoặc dữ liệu huấn luyện dành riêng cho nhiệm vụ.
Một bộ phân loại thư rác thường được thiết kế để gắn nhãn tin nhắn là thư rác hoặc không phải thư rác. Ngược lại, Foundation Model được huấn luyện rộng có thể được dùng cho phân loại, tóm tắt, trả lời câu hỏi hoặc các nhiệm vụ khác, tùy dữ liệu và thiết kế của mô hình.
Mô hình phạm vi rộng không tự động thực hiện tốt mọi nhiệm vụ. “Có thể tái sử dụng” chỉ có nghĩa mô hình có thể làm điểm khởi đầu hoặc năng lực dùng chung cho nhiều nhiệm vụ, không có nghĩa mọi kết quả đều chính xác hoặc sẵn sàng đưa vào sử dụng.
Foundation Model được huấn luyện và điều chỉnh như thế nào?
Foundation Model thường được huấn luyện trên phạm vi rộng trước khi áp dụng cho nhiệm vụ cụ thể. Hai giai đoạn cần phân biệt là pretraining và adaptation (điều chỉnh).
Pretraining là giai đoạn huấn luyện rộng. Mô hình xử lý dữ liệu và điều chỉnh các mẫu bên trong để làm việc với những loại thông tin được thể hiện trong dữ liệu đó. Với mô hình ngôn ngữ, quá trình này có thể bao gồm việc học mối quan hệ giữa các từ và đơn vị văn bản khác. Với mô hình khác, dữ liệu có thể gồm hình ảnh, âm thanh, video hoặc nhiều loại dữ liệu.
Adaptation giúp mô hình đã được huấn luyện rộng phù hợp hơn với một nhiệm vụ cụ thể. Một hình thức adaptation là fine-tuning, tức huấn luyện bổ sung trên bộ dữ liệu hẹp hơn dành riêng cho nhiệm vụ. Fine-tuning một mô hình đã được huấn luyện trước có thể hiệu quả hơn so với huấn luyện một mô hình mới từ đầu.
Một quy trình xử lý tài liệu giả định có thể diễn ra như sau:
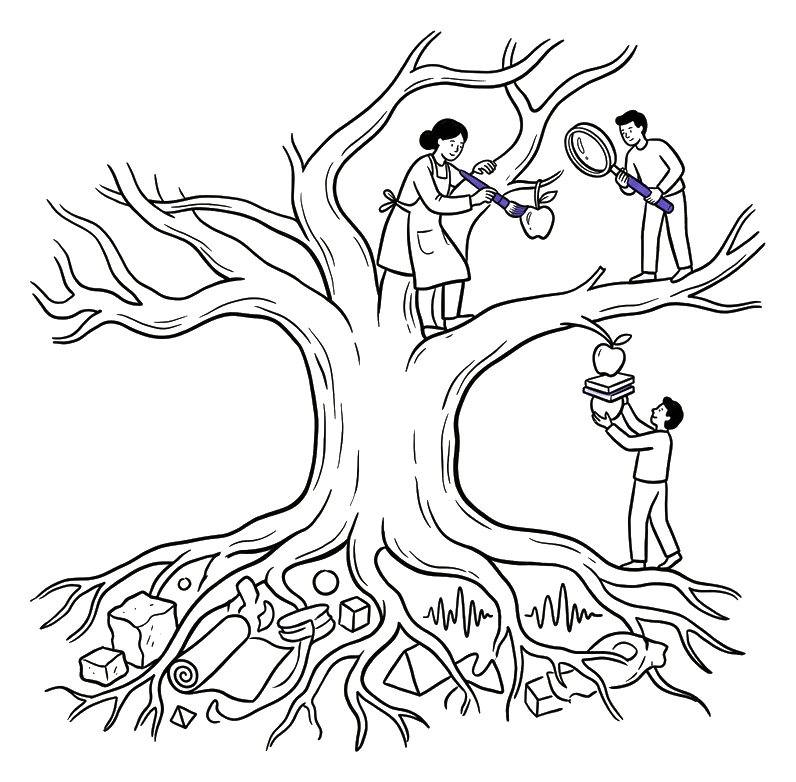
Giả sử mô hình đã học các mẫu tổng quát trong ngôn ngữ viết. Tổ chức có thể điều chỉnh mô hình bằng các ví dụ về báo cáo nội bộ được gắn nhãn theo phòng ban. Hệ thống sau điều chỉnh có thể hỗ trợ phân loại tài liệu đến. Tổ chức cũng có thể không fine-tuning mà cung cấp chỉ dẫn, ví dụ hoặc tài liệu liên quan tại thời điểm sử dụng.
Các cách tiếp cận này gồm:
- Sử dụng trực tiếp: Áp dụng mô hình đã pretraining cho một nhiệm vụ với chỉ dẫn và ngữ cảnh sẵn có.
- Thêm ngữ cảnh dành cho nhiệm vụ: Cung cấp thông tin cần thiết cho yêu cầu hiện tại, chẳng hạn tài liệu chính sách hoặc mẫu báo cáo.
- Fine-tuning: Cung cấp thêm dữ liệu huấn luyện để điều chỉnh hành vi của mô hình cho nhiệm vụ hẹp hơn.
- Xây dựng ứng dụng xung quanh mô hình: Kết nối mô hình với giao diện người dùng, quy trình doanh nghiệp, cơ sở dữ liệu hoặc quy trình rà soát.
Không cách tiếp cận nào loại bỏ nhu cầu đánh giá. Mô hình đã được điều chỉnh vẫn có thể mắc lỗi, phản ánh hạn chế trong dữ liệu hoặc hoạt động kém với các trường hợp không xuất hiện trong giai đoạn điều chỉnh.
Foundation Model và AI Model khác nhau thế nào?
AI Model là thuật ngữ rộng hơn, chỉ hệ thống tính toán có các mẫu hoặc quy tắc đã học để tạo dự đoán, quyết định, phân loại, nội dung hoặc đầu ra khác. Foundation Model là một loại AI Model cụ thể: được huấn luyện trên phạm vi rộng và thiết kế để hỗ trợ nhiều nhiệm vụ phía sau.
| Thuật ngữ | Ý nghĩa | Ví dụ |
|---|---|---|
| AI Model | Hệ thống tổng quát tạo đầu ra từ đầu vào | Bộ phân loại hóa đơn |
| Foundation Model | Mô hình AI được huấn luyện rộng và có thể tái sử dụng | Mô hình đã pretraining, được điều chỉnh cho nhiều nhiệm vụ xử lý tài liệu |
| Mô hình dành cho một nhiệm vụ hẹp | Mô hình chủ yếu được thiết kế cho một công việc cụ thể | Mô hình gắn nhãn hóa đơn theo danh mục |
Mọi Foundation Model đều là AI Model, nhưng không phải mọi AI Model đều là Foundation Model. Một mô hình chỉ phát hiện hóa đơn trùng lặp có thể là AI Model mà không phải Foundation Model vì không được pretraining trên phạm vi rộng hoặc không được thiết kế để hỗ trợ nhiều nhiệm vụ không liên quan.
Sự khác biệt nằm ở vai trò và cách huấn luyện, không chỉ ở kích thước. Không cần một ngưỡng thống nhất về số lượng tham số hoặc kích thước bộ dữ liệu để hiểu nhóm khái niệm cơ bản này.
Foundation Model và Large Language Model
Large Language Model, hay LLM, là mô hình được huấn luyện để xử lý và tạo ngôn ngữ. Đây là một loại Foundation Model quan trọng, nhưng Foundation Model cũng có thể làm việc với các loại dữ liệu khác. Google Cloud trình bày mối quan hệ cha-con này như sau: LLM là một loại Foundation Model, còn Foundation Model không chỉ giới hạn ở LLM.
| Thuật ngữ | Trọng tâm chính | Đầu ra hoặc nhiệm vụ có thể có |
|---|---|---|
| Foundation Model | Nền tảng có thể tái sử dụng trên một hoặc nhiều loại dữ liệu | Văn bản, hình ảnh, âm thanh, video, phân loại hoặc các nhiệm vụ khác |
| Large Language Model | Ngôn ngữ và văn bản | Tạo văn bản, tóm tắt, phân loại và trả lời câu hỏi |
Ví dụ, mô hình ngôn ngữ có thể hỗ trợ soạn email hoặc tóm tắt biên bản cuộc họp. Foundation Model tập trung vào hình ảnh có thể phân tích nội dung trực quan, còn mô hình tập trung vào âm thanh có thể làm việc với giọng nói hoặc âm thanh. Việc xếp mô hình vào nhóm nào phụ thuộc vào loại dữ liệu được huấn luyện và cách mô hình có thể được điều chỉnh.
Để tìm hiểu chủ đề LLM, hãy xem Large Language Model là gì?.
Foundation Model và Generative AI
Foundation Model và Generative AI mô tả các khía cạnh khác nhau của một hệ thống AI. Foundation Model là nền tảng đã được pretraining trên phạm vi rộng; Generative AI là các hệ thống hoặc năng lực tạo nội dung mới như văn bản, hình ảnh, âm thanh, video hoặc mã. Hai khái niệm này có liên quan chặt chẽ nhưng không đồng nhất.
| Thuật ngữ | Mô tả | Ví dụ |
|---|---|---|
| Foundation Model | Nền tảng đã pretraining và có thể tái sử dụng | Mô hình được huấn luyện rộng, dùng trong nhiều ứng dụng |
| Generative AI | Năng lực hoặc hệ thống tạo nội dung | Công cụ soạn email hoặc tạo hình ảnh |
| Hệ thống phân loại | Nhiệm vụ gán danh mục hoặc nhãn | Công cụ đánh dấu yêu cầu hỗ trợ là khẩn cấp |
Foundation Model có thể hỗ trợ Generative AI. Chẳng hạn, ứng dụng có thể dùng mô hình để tạo bản nháp phản hồi khách hàng. Cùng mô hình đó, hoặc phiên bản đã được điều chỉnh, cũng có thể hỗ trợ nhiệm vụ không tạo sinh như phân loại tin nhắn khách hàng vào các nhóm hỗ trợ.
Vì vậy, “Foundation Model” trả lời câu hỏi đây là loại mô hình nền tảng nào? Còn Generative AI trả lời câu hỏi hệ thống có thể làm gì với mô hình đó? Để hiểu rộng hơn về các hệ thống tạo nội dung, hãy xem Generative AI là gì?.
Foundation Model có thể làm việc với những loại dữ liệu nào?
Foundation Model có thể làm việc với văn bản, hình ảnh, âm thanh, video hoặc sự kết hợp của các loại dữ liệu này, tùy mô hình. Hệ thống xử lý nhiều hơn một loại dữ liệu thường được gọi là Multimodal AI.
Ví dụ trong công việc gồm:
1. Văn bản: Tóm tắt báo cáo hoặc phân loại tin nhắn khách hàng.
2. Hình ảnh: Kiểm tra ảnh sản phẩm để phát hiện hư hỏng nhìn thấy được hoặc trích xuất thông tin từ tài liệu được quét.
3. Âm thanh: Chuyển bản ghi cuộc họp thành văn bản hoặc xác định những phần cần theo dõi thêm.
4. Video: Phân tích các yếu tố hình ảnh hoặc lời nói được chọn trong một buổi ghi hình.
5. Nhiều loại dữ liệu: Trả lời câu hỏi bằng văn bản về hình ảnh được tải lên hoặc kết hợp bản chép lời cuộc họp với ghi chú bằng văn bản.
Đây là những cách sử dụng có thể có, không phải năng lực của mọi Foundation Model. Mô hình tập trung vào văn bản có thể không được thiết kế để xử lý hình ảnh hoặc âm thanh. Mô hình đa phương thức có thể tiếp nhận nhiều loại đầu vào nhưng vẫn hoạt động tốt hơn ở một số nhiệm vụ.
Để tìm hiểu sâu hơn về các hệ thống làm việc với nhiều loại dữ liệu, hãy xem Multimodal AI là gì?.
Vì sao dùng Foundation Model thay vì xây dựng từ đầu?
Foundation Model đã pretraining cung cấp điểm khởi đầu, thay vì buộc tổ chức phải huấn luyện mô hình mới cho từng ứng dụng. Sử dụng mô hình đã pretraining có thể giảm thời gian và nguồn lực cần thiết để phát triển một ứng dụng AI so với việc huấn luyện mô hình từ đầu.
Một nhóm có thể tiến hành như sau:
1. Bắt đầu từ nhiệm vụ: Xác định hệ thống cần làm gì, chẳng hạn phân loại yêu cầu hỗ trợ.
2. Chọn mô hình đã pretraining phù hợp: Kiểm tra khả năng xử lý loại dữ liệu và nhiệm vụ cần thiết.
3. Thử sử dụng trực tiếp: Cung cấp chỉ dẫn và ví dụ đại diện để đánh giá hoạt động của mô hình.
4. Thêm ngữ cảnh liên quan: Cung cấp chính sách, định nghĩa hoặc thông tin riêng của doanh nghiệp.
5. Điều chỉnh nếu cần: Cân nhắc fine-tuning hoặc phương pháp phát triển khác khi sử dụng trực tiếp chưa đủ.
6. Thêm rà soát và giám sát: Xác định đầu ra cần con người phê duyệt và cách phát hiện lỗi.
Ví dụ, doanh nghiệp nhỏ có thể bắt đầu bằng cách dùng mô hình đã pretraining để sắp xếp yêu cầu hỗ trợ vào các danh mục. Sau đó, doanh nghiệp cung cấp ví dụ về danh mục của mình và yêu cầu nhân viên phê duyệt các trường hợp không chắc chắn. Doanh nghiệp không nhất thiết phải phát triển mô hình mới từ đầu, nhưng vẫn cần kiểm tra mức độ phù hợp với khách hàng và quy trình.
Foundation Model không bảo đảm chi phí thấp hơn, độ chính xác cao hơn hoặc phù hợp với mọi ứng dụng. Chuẩn bị dữ liệu, kiểm thử, tích hợp, kiểm soát quyền truy cập, giám sát liên tục và rà soát bởi con người đều có thể đòi hỏi nhiều công sức.
Hạn chế và rủi ro của Foundation Model là gì?
Pretraining trên phạm vi rộng giúp mô hình linh hoạt hơn nhưng không bảo đảm tính đúng đắn, công bằng, khả năng giải thích hoặc sự phù hợp với một quyết định cụ thể. Foundation Model có thể kế thừa hoặc khuếch đại thiên lệch, tạo ra đầu ra sai về mặt thực tế và cần nhiều tài nguyên tính toán để huấn luyện.
Các hạn chế quan trọng gồm:
- Câu trả lời sai: Mô hình có thể tạo nội dung trôi chảy hoặc có vẻ hợp lý nhưng không có bằng chứng đáng tin cậy hỗ trợ. Hiện tượng này thường được gọi là AI Hallucination.
- Thiên lệch và kết quả thiếu công bằng: Các mẫu trong dữ liệu huấn luyện có thể tạo ra kết quả lệch hoặc cách đối xử không bình đẳng với cá nhân và nhóm người.
- Không phù hợp với nhiệm vụ: Mô hình hoạt động tốt trong bối cảnh này có thể không đáng tin cậy trong ngành, ngôn ngữ, nhóm người hoặc loại đầu vào khác.
- Khả năng giải thích hạn chế: Đầu ra có thể không nêu rõ và đầy đủ lý do tạo ra một kết quả cụ thể.
- Tài nguyên huấn luyện và vận hành: Phát triển và vận hành mô hình lớn có thể cần nhiều tài nguyên tính toán.
- Lo ngại về dữ liệu và quyền riêng tư: Tổ chức cần cân nhắc thông tin nào được gửi đến dịch vụ, thông tin được xử lý ra sao và quy trình có phù hợp với dữ liệu mật hoặc dữ liệu cá nhân hay không.
Trong quy trình sàng lọc hồ sơ nhân sự, mô hình có thể tạo các bản tóm tắt ứng viên nhất quán nhưng vẫn bỏ sót thông tin, phản ánh thiên lệch trong dữ liệu hoặc ví dụ huấn luyện, hoặc hiểu sai một bằng cấp. Người đánh giá cần kiểm tra các đầu ra quan trọng trước khi chúng ảnh hưởng đến quyết định tuyển dụng.
Mức độ kiểm chứng cần tương xứng với rủi ro của nhiệm vụ. Brainstorm sơ bộ có thể chỉ cần rà soát nhanh, trong khi tuyên bố gửi khách hàng, phân tích tài chính, thông tin y tế, tài liệu pháp lý hoặc quyết định tuyển dụng cần được kiểm tra cẩn thận hơn bằng bằng chứng đáng tin cậy và theo yêu cầu của tổ chức. Không có một quy trình rà soát duy nhất phù hợp với mọi trường hợp sử dụng.
Để xem hướng dẫn liên quan, hãy đọc AI Hallucination, Cách kiểm chứng câu trả lời của AI và Responsible AI là gì?.
Cần phân biệt mô hình với sản phẩm. Sản phẩm có thể bổ sung khả năng truy xuất thông tin, quy tắc nghiệp vụ, kiểm soát quyền truy cập, ghi nhật ký, rà soát bởi con người hoặc các thành phần khác quanh Foundation Model. Việc mô hình được huấn luyện rộng không tự mô tả mọi hành vi hoặc cách sản phẩm sử dụng và xử lý dữ liệu.
Mô hình tư duy đơn giản cần nhớ
Foundation Model là nền tảng AI đã được pretraining trên phạm vi rộng, có thể hỗ trợ nhiều nhiệm vụ và ứng dụng. Mô hình có thể làm việc với văn bản, hình ảnh, âm thanh, video hoặc nhiều loại dữ liệu, nhưng năng lực cụ thể phụ thuộc vào từng mô hình.
Quy trình thường là:
Huấn luyện rộng tạo ra nền tảng có thể tái sử dụng → điều chỉnh hoặc sử dụng cho nhiệm vụ cụ thể tạo ra năng lực ứng dụng → đánh giá quyết định kết quả có phù hợp để sử dụng hay không.
Bước đánh giá quyết định liệu đầu ra có phù hợp để sử dụng hay không. Foundation Model có thể giúp phát triển linh hoạt hơn và giảm nhu cầu bắt đầu từ đầu, nhưng vẫn có thể tạo ra đầu ra sai hoặc thiên lệch. Hãy xem mô hình là một thành phần trong quy trình AI, không phải nguồn sự thật độc lập.
Để phát triển các kỹ năng liên quan, hãy tiếp tục với AI Literacy và Cách kiểm chứng câu trả lời của AI.