Mô hình ngôn ngữ lớn (Large Language Model – LLM) là hệ thống AI được huấn luyện trên lượng lớn dữ liệu ngôn ngữ để xử lý và tạo văn bản. LLM hỗ trợ soạn email, tóm tắt tài liệu, trả lời câu hỏi, dịch văn bản và tạo mã.
Khi bạn sử dụng chatbot AI, câu trả lời trôi chảy có thể xuất hiện gần như ngay lập tức. Tuy nhiên, hệ thống thường không tìm một câu trả lời hoàn chỉnh rồi sao chép lại. Mô hình chuyển đầu vào thành các token, sử dụng mẫu ngôn ngữ và ngữ cảnh đã học, sau đó tạo phản hồi từng phần.
Tóm tắt cốt lõi (Key Takeaways)
- LLM là gì: LLM là mô hình deep learning học các mẫu thống kê trong ngôn ngữ để xử lý và tạo văn bản. Đây là một loại Generative AI.
- LLM hoạt động như thế nào: Trong quá trình huấn luyện, mô hình điều chỉnh các tham số bên trong thông qua những nhiệm vụ dự đoán lặp đi lặp lại. Khi inference, mô hình chuyển prompt thành các token và dự đoán phản hồi từng token một.
- Kiểm chứng đầu ra: LLM có thể tạo văn bản trau chuốt nhưng vẫn chứa nhận định thiếu cơ sở, lỗi thời hoặc không chính xác. Với công việc quan trọng, cần cung cấp nguồn phù hợp và kiểm tra kết quả.
Large Language Model là gì?
Large Language Model là mô hình deep learning được huấn luyện trên lượng lớn dữ liệu ngôn ngữ để xử lý và tạo văn bản. Mô hình học mối quan hệ giữa từ, cụm từ, cấu trúc và các mẫu ngôn ngữ khác, thay vì lưu sẵn câu trả lời hoàn chỉnh cho mọi câu hỏi. IBM mô tả LLM là các mô hình deep learning được xây dựng để hiểu và tạo ngôn ngữ tự nhiên cho nhiều loại tác vụ.
Có thể hình dung LLM như một hệ thống đã tiếp xúc với nhiều ví dụ về cách ngôn ngữ được viết và cách các ý tưởng thường xuất hiện cùng nhau. Khi nhận prompt, hệ thống dùng những mẫu đó để xây dựng phản hồi. Cách mô tả này không có nghĩa mô hình ghi nhớ mọi tài liệu như một thư viện có thể tìm kiếm hoặc hiểu thế giới giống con người.
LLM là một loại Generative AI, nhóm rộng hơn gồm các hệ thống tạo nội dung mới như văn bản, hình ảnh, âm thanh, video hoặc mã. LLM chủ yếu tập trung vào ngôn ngữ và đầu ra dạng văn bản.
Quy trình giản lược: Từ prompt đến câu trả lời
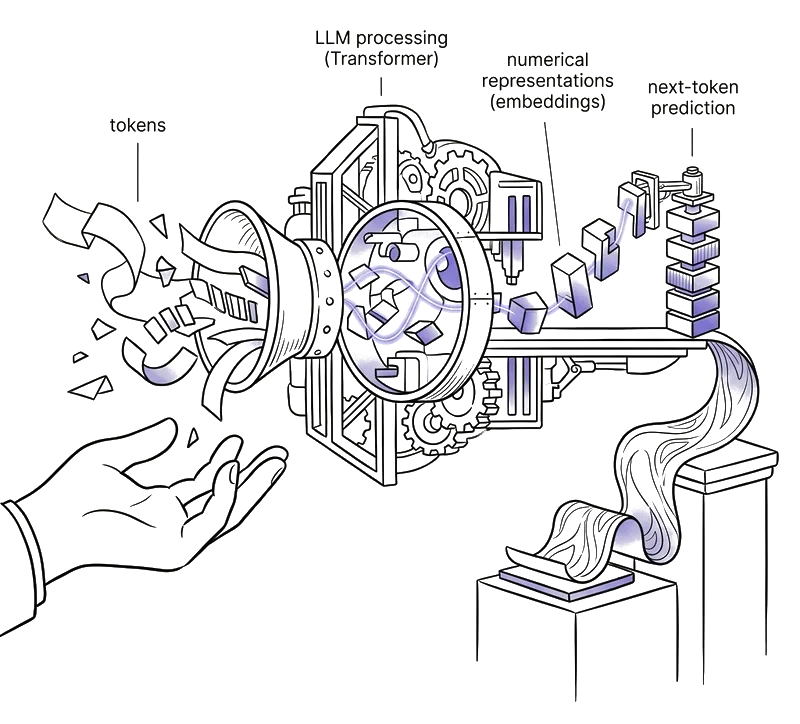
LLM thường chuyển prompt thành token, xử lý quan hệ giữa các token bằng Transformer, rồi tạo phản hồi từng token một. Cách triển khai cụ thể khác nhau giữa các mô hình, nhưng quy trình cấp cao thường gồm:
1. Tiếp nhận prompt. Hệ thống nhận chỉ dẫn, câu hỏi hoặc tài liệu bạn cung cấp. Các chỉ dẫn khác và nội dung cuộc trò chuyện cũng có thể được dùng làm ngữ cảnh.
2. Chia văn bản thành token. Văn bản được chia thành các đơn vị nhỏ hơn gọi là token. Một token có thể là cả từ, một phần của từ, dấu câu hoặc một đơn vị văn bản khác.
3. Chuyển token thành biểu diễn số. Mỗi token được ánh xạ thành các con số để mô hình xử lý. Những biểu diễn này được gọi là embeddings (biểu diễn nhúng).
4. Xử lý mối quan hệ và ngữ cảnh. Các lớp Transformer phân tích cách các token liên hệ với nhau, giúp mô hình sử dụng phần văn bản xung quanh khi diễn giải một cụm từ.
5. Dự đoán token tiếp theo. Dựa trên prompt và phần văn bản đã tạo, mô hình tính toán các token có thể xuất hiện rồi áp dụng quy trình tạo sinh để chọn một token.
6. Lặp lại quy trình. Token mới trở thành một phần của phản hồi. Mô hình tiếp tục dự đoán token tiếp theo cho đến khi đạt điểm dừng hoặc hoàn tất đầu ra.
Giai đoạn tạo phản hồi này được gọi là inference. Đầu ra được xây dựng từng bước, thay vì được truy xuất như một câu trả lời hoàn chỉnh từ cơ sở dữ liệu. Chẳng hạn, mô hình có thể tạo email tóm tắt cuộc họp vì đã học các mẫu của email, bản tóm tắt và ngôn ngữ công sở. Mô hình không tự động biết mọi chi tiết trong email có được dữ liệu thực tế hỗ trợ hay không.
Nếu được yêu cầu viết email dựa trên ghi chú cuộc họp, mô hình xử lý ghi chú và chỉ dẫn, nhận diện các mẫu thường có trong email chuyên nghiệp rồi tạo phản hồi từng bước. Mô hình không tự kiểm tra độc lập độ chính xác của ghi chú, trừ khi bạn cung cấp nguồn đáng tin cậy và yêu cầu làm việc dựa trên nguồn đó.
Văn bản trở thành token và embeddings như thế nào?
Văn bản được chia thành token rồi chuyển thành embeddings, tức các biểu diễn số để các lớp tính toán có thể xử lý.
Token là các đơn vị mô hình xử lý
Tokenization (phân tách token) chia văn bản thành các đơn vị nhỏ hơn mà máy có thể đọc. Một token có thể là từ hoàn chỉnh, một phần của từ, dấu câu hoặc một đoạn văn bản khác. Một từ ít phổ biến có thể bị chia thành nhiều phần; cách chia phụ thuộc vào tokenizer của từng mô hình.
Token không luôn tương đương với một từ. Cùng một tài liệu có thể chứa số token khác nhau tùy vào thuật ngữ kỹ thuật, tên riêng, mã, số hoặc ngôn ngữ được sử dụng.
Khi tóm tắt báo cáo, mô hình không xử lý trang báo cáo theo cách con người nhìn thấy. Nó xử lý văn bản và các đầu vào được hỗ trợ thành những đơn vị có thể biểu diễn và phân tích.
Embeddings chuyển token thành biểu diễn số hữu ích
Embedding là biểu diễn số của một token. Các con số này giúp mô hình biểu diễn quan hệ giữa các token và điều chỉnh những biểu diễn đó trong quá trình xử lý văn bản; chúng không phải định nghĩa mà con người có thể đọc.
Các thuật ngữ thường xuất hiện trong những ngữ cảnh liên quan có thể nhận được các biểu diễn giúp mô hình phân biệt quan hệ giữa chúng. Biểu diễn của một từ cũng được tinh chỉnh dựa trên câu xung quanh. Từ “draft” có thể chỉ việc soạn hợp đồng, luồng khí qua văn phòng hoặc bản sơ bộ của tài liệu. Các token lân cận giúp xác định nghĩa phù hợp.
IBM giải thích rằng token được ánh xạ thành các vector số gọi là embeddings, sau đó các lớp Transformer điều chỉnh những biểu diễn này thành các dạng giàu ngữ cảnh hơn. Mô hình chuyển ngôn ngữ thành các mẫu số để các lớp xử lý có thể so sánh và liên kết các phần của đầu vào.
Transformer sử dụng ngữ cảnh để liên hệ các từ như thế nào?
Transformer giúp LLM phân tích quan hệ giữa các token trong chuỗi, còn self-attention giúp xác định token nào liên quan tại một điểm cụ thể trong văn bản.
Transformer là một kiến trúc mạng nơ-ron thường được LLM sử dụng để xử lý chuỗi token. Cơ chế trung tâm của kiến trúc này là self-attention (cơ chế tự chú ý), cho phép mô hình liên kết các token ở gần nhau và, trong phạm vi ngữ cảnh khả dụng, cả những token cách xa nhau hơn. Phần giải thích của IBM về LLM mô tả self-attention là cách tính toán mối quan hệ và sự phụ thuộc giữa các token.
- “Please draft the contract before Friday.”
- “The draft from the window made the room cold.”
Từ “draft” có mặt trong cả hai câu, nhưng các từ xung quanh gợi ra những nghĩa khác nhau. Transformer giúp mô hình sử dụng các mối quan hệ đó thay vì xem từ này như một nhãn tách biệt.
Cơ chế tương tự hỗ trợ việc liên kết đại từ với nội dung tham chiếu trước đó. Nếu một đoạn văn nói Maria đã phê duyệt ngân sách rồi tiếp tục nói “cô ấy yêu cầu sửa đổi”, ngữ cảnh xung quanh cung cấp tín hiệu để diễn giải “cô ấy”. Đây là xử lý dựa trên mẫu, không phải sự chú ý có ý thức hay khả năng hiểu như con người.
Prompt rõ ràng về đối tượng đọc, định dạng, tài liệu nguồn và các ràng buộc cung cấp nhiều tín hiệu hữu ích hơn prompt mơ hồ.
LLM học trong quá trình pretraining như thế nào?
Trong pretraining (tiền huấn luyện), LLM học các mẫu ngôn ngữ rộng bằng cách dự đoán token hoặc mục tiêu huấn luyện khác, đo sai số và điều chỉnh các tham số bên trong. Giai đoạn này sử dụng training data (dữ liệu huấn luyện), thường là các tập hợp văn bản đã được chuẩn bị, lọc và xử lý trước. Bộ dữ liệu và chính sách cụ thể khác nhau giữa các mô hình, nên mô tả tổng quát này không đại diện cho mọi hệ thống thương mại.
Quy trình học gồm:
1. Chuẩn bị ví dụ huấn luyện. Văn bản được thu thập và xử lý để dùng cho việc học. Khâu này có thể gồm làm sạch, định dạng, loại bỏ hoặc xử lý các nội dung có vấn đề.
2. Yêu cầu dự đoán. Mô hình nhận một phần của chuỗi và cố gắng dự đoán token tiếp theo hoặc một mục tiêu huấn luyện khác.
3. Đo sai số. Hệ thống so sánh dự đoán với mục tiêu và tính toán mức độ chênh lệch.
4. Điều chỉnh các tham số bên trong. Mô hình cập nhật các giá trị số bên trong mạng để cải thiện những dự đoán sau.
5. Lặp lại trên nhiều ví dụ. Chu kỳ này giúp mô hình học các mẫu lặp lại trong ngữ pháp, cách diễn đạt, cấu trúc và mối liên hệ.
Quy trình này thường được gọi là self-supervised learning (học tự giám sát) vì chính văn bản cung cấp nhiều mục tiêu dự đoán. Chẳng hạn, sau khi thấy “Please attach the quarterly…”, mô hình có thể học token hoặc chuỗi thường xuất hiện tiếp theo. Nhiều ví dụ giúp mô hình nhận ra mẫu trong email, báo cáo, phần giải thích, cuộc trò chuyện và các dạng ngôn ngữ khác.
Mô hình không được dạy một phần giải thích do con người viết cho mọi sự thật. Nó được điều chỉnh thông qua nhiều nhiệm vụ dự đoán. Vì vậy, mô hình có thể tạo ngôn ngữ đúng ngữ pháp, có cấu trúc tốt nhưng vẫn đưa ra nhận định không có cơ sở.
Quy trình trên không xác định chính xác sách, website, kho mã hoặc nguồn khác đã được một mô hình thương mại cụ thể sử dụng. Những nhận định đó cần dựa trên tài liệu của nhà cung cấp liên quan.
Pretraining, fine-tuning và inference là các giai đoạn khác nhau
Pretraining xây dựng năng lực ngôn ngữ rộng, fine-tuning điều chỉnh hành vi cho mục đích hẹp hơn, còn inference tạo đầu ra từ prompt mới.
| Giai đoạn | Mục đích chính | Đầu vào điển hình | Kết quả thực tế |
|---|---|---|---|
| Pretraining | Học các mẫu ngôn ngữ rộng | Tập hợp văn bản lớn | Mô hình đa dụng |
| Fine-tuning | Điều chỉnh mô hình cho tác vụ hoặc phong cách hẹp hơn | Bộ dữ liệu nhỏ hơn, dành riêng cho tác vụ | Hành vi có mục tiêu hơn |
| Inference | Tạo đầu ra từ đầu vào mới | Prompt và ngữ cảnh khả dụng của bạn | Phản hồi, dự đoán hoặc văn bản được tạo |
Pretraining cho mô hình tiếp xúc với nhiều ví dụ và liên tục điều chỉnh các tham số bên trong.
Fine-tuning điều chỉnh mô hình đã huấn luyện rộng cho mục đích cụ thể hơn, chẳng hạn tóm tắt, phân loại hoặc trả lời hỗ trợ khách hàng bằng bộ dữ liệu nhỏ hơn. Fine-tuning thay đổi xu hướng phản hồi trước các đầu vào liên quan, nhưng không có nghĩa mọi sản phẩm dùng cùng một quy trình. IBM phân biệt fine-tuning với pretraining và mô tả fine-tuning là hình thức điều chỉnh hẹp hơn, cần ít tài nguyên hơn so với huấn luyện từ đầu.
Inference diễn ra khi mô hình đã huấn luyện được đưa vào sử dụng. Nếu nhân viên hỗ trợ gửi tin nhắn của khách và yêu cầu viết phản hồi lịch sự, mô hình đang thực hiện inference. Prompt định hướng phản hồi hiện tại; thông thường, nó không viết lại vĩnh viễn mô hình nền. Cuộc trò chuyện có thể ảnh hưởng đến đầu ra vì được đưa vào ngữ cảnh, nhưng điều này khác với việc thay đổi các tham số đã huấn luyện.
LLM tạo phản hồi từng token một như thế nào?
Trong inference, LLM ước tính token tiếp theo dựa trên prompt và phần phản hồi đã tạo, chọn hoặc lấy mẫu một token, rồi lặp lại quy trình cho đến khi đạt điểm kết thúc hoặc giới hạn hệ thống.
Giả sử bạn yêu cầu viết lại email bắt đầu bằng “Thank you for reviewing the proposal.” Những từ đầu tiên thiết lập giọng điệu và cấu trúc câu. Sau đó, chúng trở thành một phần của ngữ cảnh dùng để tạo phần tiếp theo.
Chuỗi đơn giản hóa là:
1. Đọc prompt và ngữ cảnh khả dụng.
2. Ước tính các token tiếp theo có thể xuất hiện.
3. Chọn hoặc lấy mẫu một token theo các thiết lập tạo sinh.
4. Thêm token vào phản hồi.
5. Dùng ngữ cảnh đã mở rộng để dự đoán token tiếp theo.
6. Dừng khi phản hồi đạt điểm kết thúc phù hợp hoặc chạm giới hạn hệ thống.
Quy trình này có thể tạo đoạn văn, bản tóm tắt, bản dịch và mã, ngay cả khi cách diễn đạt chính xác đó không xuất hiện dưới dạng một đoạn hoàn chỉnh trong prompt. Nó cũng cho thấy giới hạn của mô hình: phần tiếp nối có khả năng phù hợp dựa trên mẫu và ngữ cảnh, không phải bằng chứng rằng từng câu đều được hỗ trợ.
Mô hình không nhất thiết luôn chọn token có xác suất toán học cao nhất. Thiết lập tạo sinh và thiết kế hệ thống có thể ảnh hưởng đến mức độ dễ đoán hoặc đa dạng của đầu ra.
Context Window có nghĩa là gì?
Context Window (cửa sổ ngữ cảnh) là số lượng token tối đa mà LLM có thể sử dụng cùng lúc khi xử lý một tương tác và tạo văn bản. Nó có thể gồm prompt, tài liệu, nội dung cuộc trò chuyện, chỉ dẫn và phản hồi đang được tạo. IBM định nghĩa context window là số lượng token tối đa mà mô hình có thể nhìn thấy và sử dụng tại một thời điểm.
Với tài liệu chính sách dài hoặc cuộc trao đổi dự án kéo dài, nếu nội dung vượt quá ngữ cảnh khả dụng, hệ thống có thể không sử dụng được toàn bộ tài liệu trong yêu cầu hiện tại. Kết quả tóm tắt vì vậy phụ thuộc vào phần nội dung thực sự được cung cấp và khả dụng cho mô hình.
Context Window không phải bộ nhớ vĩnh viễn. Nó chỉ mô tả những gì mô hình có thể sử dụng trong một ngữ cảnh xử lý cụ thể và không chứng minh hệ thống sẽ giữ lại thông tin cho các cuộc trò chuyện sau. Tính năng bộ nhớ hoặc cuộc trò chuyện riêng của một số sản phẩm cần được xem xét trong tài liệu và đánh giá quyền riêng tư riêng.
Context Window lớn hơn cũng không bảo đảm mô hình sử dụng hoàn hảo mọi chi tiết. Tên, con số, nghĩa vụ và ngoại lệ quan trọng vẫn cần được đối chiếu với nguồn.
LLM có thể làm gì trong công việc hằng ngày?
LLM phù hợp với các tác vụ chuyển đổi, sắp xếp, giải thích hoặc tạo ngôn ngữ. Các ứng dụng phổ biến gồm:
1. Soạn thảo và viết lại: Chuyển gạch đầu dòng thành email, điều chỉnh giọng điệu hoặc tạo bản nháp báo cáo.
2. Tóm tắt: Cô đọng ghi chú cuộc họp, chính sách, đoạn nghiên cứu hoặc phản hồi khách hàng được cung cấp.
3. Trả lời câu hỏi: Giải thích nội dung kỹ thuật hoặc trả lời câu hỏi về tài liệu trong ngữ cảnh khả dụng.
4. Dịch: Tạo bản dịch nháp để người có chuyên môn kiểm tra ý nghĩa, giọng điệu và thuật ngữ.
5. Phân loại và trích xuất chủ đề: Nhóm nhận xét khảo sát, xác định chủ đề lặp lại hoặc gắn nhãn yêu cầu hỗ trợ.
6. Hỗ trợ hội thoại: Giúp đội ngũ dịch vụ soạn phản hồi hoặc hướng dẫn người dùng.
7. Tạo mã: Gợi ý mã, giải thích lỗi hoặc tạo bản nháp cho công thức hay script.
Các ứng dụng này là hình thức hỗ trợ, không phải thẩm quyền tự động. LLM có thể chuyển ghi chú cuộc họp thành danh sách việc cần làm, nhưng quản lý dự án vẫn phải xác nhận người phụ trách và thời hạn. Tương tự, công thức bảng tính, phản hồi khách hàng và nội dung báo cáo cần được kiểm thử hoặc kiểm tra trước khi sử dụng.
Elastic liệt kê việc tạo văn bản, các tác vụ ngôn ngữ liên quan đến tóm tắt, hệ thống hội thoại và tạo mã trong số các ứng dụng của LLM. Kết quả phụ thuộc vào chất lượng đầu vào, mức độ phù hợp của tác vụ và quy trình xem xét đầu ra.
Vì sao LLM có thể nghe có vẻ đúng nhưng vẫn sai?
LLM có thể tạo ngôn ngữ trau chuốt mà không bảo đảm các nhận định là đúng. Mô hình tạo văn bản từ mẫu đã học và ngữ cảnh được cung cấp; những mẫu đó đôi khi dẫn đến phản hồi nghe phù hợp dù nhận định thiếu cơ sở, lỗi thời hoặc không chính xác.
Lỗi này thường được gọi là AI hallucination (ảo giác AI): đầu ra có vẻ hợp lý nhưng không được bằng chứng liên quan hỗ trợ. Khi được yêu cầu cung cấp nguồn cho một nhận định ít phổ biến, mô hình có thể tạo câu trả lời giống trích dẫn nhưng vẫn cần kiểm tra. Khi được yêu cầu tóm tắt mà không có văn bản nguồn, mô hình có thể lấp đầy phần thiếu bằng nội dung nghe hợp lý.
Các vấn đề có thể gồm:
- Sự thật không có nguồn hỗ trợ hoặc tài liệu tham khảo bị bịa
- Số liệu, ngày tháng, tên hoặc trích dẫn không chính xác
- Thông tin đã lỗi thời
- Hiệu quả yếu trong các tác vụ suy luận phức tạp
- Các mẫu thiên lệch hoặc lệch lạc kế thừa từ dữ liệu huấn luyện
- Diễn giải sai chỉ dẫn mơ hồ hoặc ngữ cảnh dài
Tổng quan của Đại học Stanford về LLM lưu ý rằng các hệ thống này có thể tạo đầu ra hợp lý nhưng không chính xác hoặc vô nghĩa vì dựa vào mẫu đã học thay vì khả năng hiểu giống con người. Văn phong trôi chảy là đặc tính của phản hồi được tạo ra, không phải bằng chứng câu trả lời đã được kiểm chứng độc lập.
Cách sử dụng đầu ra của LLM có trách nhiệm
Sử dụng LLM cho công việc quan trọng cần bắt đầu từ nguồn phù hợp, yêu cầu rõ ràng, kiểm chứng đầu ra và duy trì trách nhiệm ở con người.
1. Bắt đầu từ nguồn đã được phê duyệt. Cung cấp chính sách, ghi chú, dữ liệu hoặc yêu cầu liên quan khi muốn mô hình làm việc dựa trên thông tin cụ thể.
2. Nêu rõ tác vụ và các ràng buộc. Chỉ định đối tượng đọc, định dạng, độ dài, giọng điệu, giả định và cách xử lý khi thiếu thông tin.
3. Yêu cầu bản nháp hoặc phân tích. Xem phản hồi là hỗ trợ được tạo ra, không phải quyết định cuối cùng.
4. Kiểm tra các nhận định quan trọng. Đối chiếu tên, số liệu, trích dẫn, ngày tháng, phép tính và kết luận với nguồn đáng tin cậy.
5. Bảo vệ thông tin nhạy cảm. Không dán mật khẩu, API key, mã bảo mật, mã nguồn mật, thông tin khách hàng riêng tư, mã định danh cá nhân, hồ sơ tài chính hoặc hợp đồng hạn chế vào công cụ nếu chưa hiểu cách sử dụng được phê duyệt và chính sách dữ liệu của công cụ.
6. Giữ trách nhiệm ở con người. Người có kiến thức phù hợp cần phê duyệt các quyết định ảnh hưởng đến khách hàng, nhân viên, tiền bạc, an toàn, nghĩa vụ pháp lý, quyền riêng tư hoặc tuân thủ.
Cần phân biệt việc nhà cung cấp sử dụng nội dung người dùng gửi để huấn luyện mô hình với việc lưu prompt, ghi nhật ký tương tác hoặc giữ tệp trong một khoảng thời gian. Quy trình inference tự nó không chứng minh dữ liệu người dùng không được lưu. Trước khi sử dụng thông tin nhạy cảm, hãy kiểm tra chính sách hiện hành của dịch vụ về quyền riêng tư, thời hạn lưu trữ và dữ liệu huấn luyện.
Với email gửi khách hàng hoặc báo cáo nội bộ, quy trình phù hợp là cung cấp nguồn đã được phê duyệt, yêu cầu tạo bản nháp, kiểm tra từng nhận định, đối chiếu chi tiết quan trọng với nguồn, loại bỏ thông tin nhạy cảm không cần thiết và để con người đưa ra quyết định cuối cùng.
Huấn luyện dạy LLM các mẫu ngôn ngữ rộng; tokenization chuyển văn bản thành các đơn vị có thể xử lý; embeddings và Transformer biểu diễn, liên hệ các đơn vị đó; còn inference tạo câu trả lời từng token một. Quy trình này giải thích cả tính hữu ích lẫn giới hạn của LLM: mô hình hỗ trợ soạn thảo, tóm tắt, giải thích và tìm hiểu, nhưng vẫn cần ngữ cảnh, kiểm chứng và phán đoán của con người.