Embeddings là các biểu diễn bằng số do mô hình Machine Learning tạo ra, giúp hệ thống AI so sánh mối quan hệ giữa những đối tượng như văn bản, hình ảnh và âm thanh.
Các con số riêng lẻ trong embedding thường không có ý nghĩa trực tiếp với con người. Mẫu hình tổng thể giúp hệ thống ước tính những đối tượng nào có liên quan. Ví dụ, AI có thể chuyển câu hỏi về số ngày nghỉ phép và các tài liệu nhân sự thành embeddings, rồi tìm tài liệu phù hợp nhất ngay cả khi cách diễn đạt khác nhau.
Bài viết giải thích embeddings mà không yêu cầu kiến thức toán học hay lập trình. Nội dung tập trung vào mối liên hệ giữa embeddings và vector, cách similarity search hoạt động, các ứng dụng phổ biến và lý do độ tương đồng không chứng minh tính chính xác.
Tóm tắt cốt lõi (Key Takeaways)
- Là gì: Embedding là biểu diễn bằng số do mô hình tạo ra cho một đối tượng như câu, hình ảnh hoặc tài liệu.
- Hoạt động thế nào: Hệ thống AI so sánh các embedding dưới dạng vector. Những đối tượng có mẫu hình liên quan có thể nằm gần nhau hơn trong một không gian toán học.
- Dùng để làm gì: Embeddings hỗ trợ semantic search, sắp xếp tài liệu, hệ thống đề xuất và các quy trình retrieval, nhưng không bảo đảm tính đúng, đầy đủ hay khả năng hiểu giống con người.
Embeddings là gì?
Embedding là một danh sách các con số do mô hình Machine Learning tạo ra để biểu diễn những mối quan hệ hữu ích trong dữ liệu. Dữ liệu có thể là một từ, câu, đoạn văn, tài liệu, hình ảnh, đoạn âm thanh hoặc loại đối tượng khác. Mô hình chuyển đầu vào sang dạng số để hệ thống có thể so sánh. (Cloudflare Learning Center)
Ví dụ, nhân viên có thể hỏi: “Tôi được chuyển bao nhiêu ngày nghỉ phép sang năm sau?” Trong khi đó, tài liệu chính sách lại có tiêu đề “Quy định chuyển ngày phép năm”. Embeddings cho phép hệ thống biểu diễn cả câu hỏi và tài liệu, sau đó so sánh mối quan hệ mà mô hình đã học giữa chúng.
Các con số này không phải định nghĩa từ điển của văn bản. Chúng là dạng biểu diễn để máy xử lý, thường phục vụ những tác vụ như tìm nội dung liên quan. Vì vậy, embedding vẫn hữu ích dù con người không thể diễn giải từng con số riêng lẻ.
Embeddings biểu diễn ý nghĩa như thế nào?
Embeddings biểu diễn mối quan hệ thông qua mẫu hình và vị trí của các con số. Mô hình xử lý đầu vào rồi tạo ra một vector – danh sách số có cấu trúc – nhằm phản ánh những mối quan hệ đã học trong quá trình Machine Learning.
Quy trình cơ bản gồm:
1. Bắt đầu với một đối tượng. Đó có thể là câu hỏi của khách hàng, một đoạn chính sách hoặc hình ảnh sản phẩm.
2. Xử lý bằng embedding model. Mô hình nhận diện các mẫu hình trong đầu vào dựa trên dữ liệu huấn luyện.
3. Tạo ra một vector. Kết quả là danh sách các con số dùng để biểu diễn đối tượng cho mục đích so sánh.
4. So sánh với các vector khác. Những đối tượng liên quan có thể nằm gần nhau hơn những đối tượng không liên quan trong không gian toán học của mô hình.
Ví dụ, “chính sách hoàn tiền cho khách hàng” và “quy định bồi hoàn cho người mua” có thể được xem là liên quan vì cùng nói về một chủ đề kinh doanh. “Lịch vệ sinh bếp văn phòng” có khả năng ít liên quan hơn vì thuộc chủ đề khác. Hệ thống không đọc các cụm từ theo cách con người đọc mà so sánh những mẫu hình mô hình đã học.
Trong ngữ cảnh này, ý nghĩa chỉ những mối quan hệ hữu ích mà mô hình nắm bắt cho một tác vụ cụ thể. Điều đó không có nghĩa hệ thống có trải nghiệm, ý định hoặc sự hiểu biết đầy đủ như con người.
Embedding khác vector như thế nào?
Vector là một cấu trúc toán học tổng quát, có thể biểu diễn dưới dạng danh sách các con số theo thứ tự. Embedding là một vector do mô hình Machine Learning tạo ra để biểu diễn những mối quan hệ hữu ích giữa các đối tượng. Mọi embedding đều là vector, nhưng không phải vector nào cũng là embedding.
| Thuật ngữ | Ý nghĩa đơn giản | Ví dụ |
|---|---|---|
| Vector | Một danh sách số theo thứ tự, dùng cho các phép toán hoặc mục đích biểu diễn | Một hàng số liệu doanh thu |
| Embedding | Một vector do mô hình tạo ra, dùng để biểu diễn mối quan hệ giữa các đối tượng dữ liệu | Biểu diễn một tài liệu cho semantic search |
| Embedding model | Mô hình Machine Learning tạo embedding từ dữ liệu đầu vào | Mô hình chuyển câu hỏi thành các vector có thể tìm kiếm |
Một hàng trong bảng tính chứa doanh thu theo tháng chỉ là danh sách các con số, không tự động trở thành embedding. Embedding được tạo ra để so sánh một đối tượng với những đối tượng khác, chẳng hạn tài liệu, câu hỏi, hình ảnh hoặc đoạn âm thanh. (Cloudflare Learning Center)
Similarity search hoạt động như thế nào?
Similarity search tìm những đối tượng đã lưu có embedding tương đối gần với embedding của truy vấn mới. “Gần” là kết quả của phép so sánh toán học giữa các vector, không phải khoảng cách vật lý và cũng không chứng minh hai đối tượng giống hệt nhau.
Quy trình thông thường gồm:
1. Chuẩn bị nội dung đã lưu. Tài liệu, bài viết hỗ trợ hoặc mô tả sản phẩm được chuyển thành embedding.
2. Lưu các biểu diễn. Embeddings được lưu để phục vụ tìm kiếm.
3. Chuyển truy vấn mới. Câu hỏi của người dùng được chuyển thành embedding bằng một mô hình phù hợp.
4. So sánh các vector. Hệ thống đo mức độ liên quan giữa embedding của truy vấn và các embedding đã lưu.
5. Trả về các kết quả tiềm năng. Hệ thống đưa ra những đối tượng có độ tương đồng tương đối cao nhất cho bước tiếp theo.
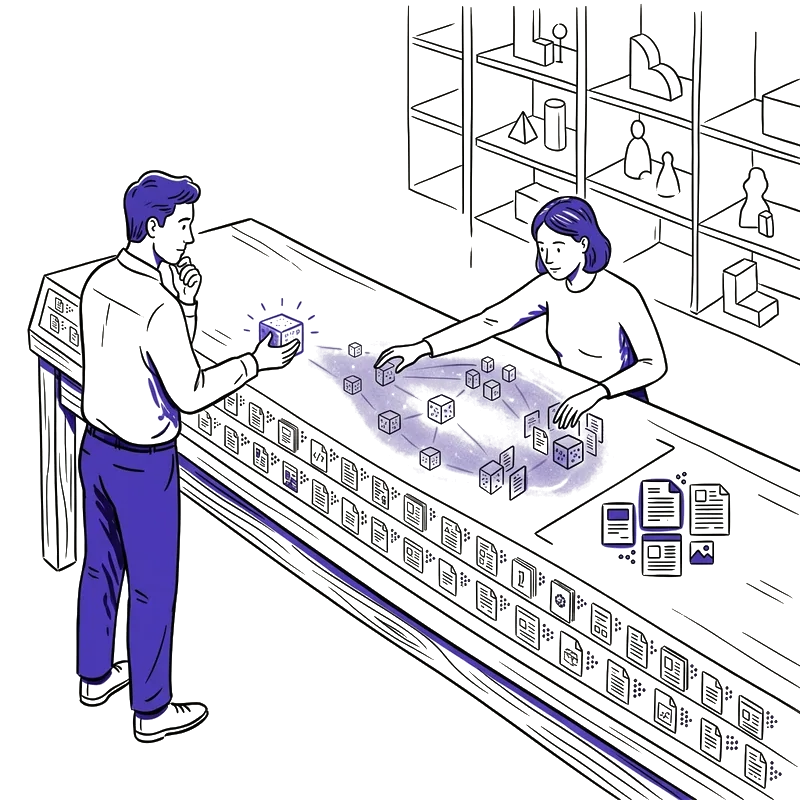
Ví dụ, nhóm hỗ trợ khách hàng có thể tạo embedding cho các hướng dẫn sử dụng sản phẩm. Khi khách hàng hỏi: “Vì sao thiết bị của tôi dừng sạc ở mức 80 phần trăm?”, hệ thống tạo embedding cho câu hỏi rồi tìm những phần liên quan, chẳng hạn mục “Bảo vệ pin và giới hạn sạc”, dù khách hàng không dùng đúng các từ đó.
Kết quả chỉ là tập hợp các đối tượng có khả năng liên quan, không phải phán đoán cuối cùng. Con người hoặc hệ thống khác vẫn cần kiểm tra đoạn được chọn có áp dụng cho đúng sản phẩm và tình huống hay không. (Cloudflare Learning Center)
Embeddings được tạo ra như thế nào?
Embedding model nhận đầu vào và tạo ra một vector dựa trên các mẫu hình đã học trong quá trình Machine Learning. Ở mức khái quát, mô hình xử lý đầu vào, mã hóa các mối quan hệ hữu ích thành dạng số rồi trả về vector để lưu trữ hoặc so sánh.
Với một tài liệu tại nơi làm việc, quy trình có thể gồm:
1. Chọn một đoạn trong sổ tay nhân viên.
2. Embedding model xử lý đoạn văn.
3. Mô hình xuất ra vector biểu diễn các mẫu hình trong văn bản.
4. Lưu vector cùng thông tin nhận diện đoạn văn gốc.
5. Xử lý câu hỏi của nhân viên theo cách tương tự.
6. So sánh vector của câu hỏi với các vector tài liệu đã lưu.
Đó là ý tưởng cơ bản của embedding: tạo ra một vector, thường cũng gọi là embedding, để phục vụ so sánh. Quá trình huấn luyện kỹ thuật phía sau embedding model có thể liên quan đến deep learning, nhưng người mới bắt đầu không cần hiểu kiến trúc mô hình để nắm được vai trò thực tế của nó. (Cloudflare Learning Center)
Chất lượng kết quả phụ thuộc vào mô hình, dữ liệu đầu vào và cách hệ thống sử dụng biểu diễn đó. Vector không giữ lại mọi chi tiết của đối tượng gốc theo cách có thể khôi phục hoàn hảo; nó được tạo ra để hỗ trợ so sánh, không thay thế nguồn ban đầu.
Embeddings được dùng trong semantic search như thế nào?
Semantic search tìm nội dung liên quan đến ý nghĩa hoặc chủ đề của truy vấn, thay vì chỉ khớp chính xác từ ngữ. Text embeddings có thể biểu diễn từ, câu, đoạn văn hoặc tài liệu dài hơn, giúp hệ thống so sánh truy vấn với nội dung ở nhiều cấp độ. (Cloudflare Learning Center; Lightly, “Embeddings in Machine Learning”)
| Cách tìm kiếm | Chủ yếu so sánh | Ví dụ |
|---|---|---|
| Khớp từ khóa | Từ chính xác hoặc dạng từ gần giống | Tìm các trang có chứa “nghỉ phép cho cha mẹ” |
| Semantic search | Các khái niệm liên quan và mẫu hình mà mô hình đã học | Có thể tìm thấy “sắp xếp làm việc từ xa cho người mới có con” |
| Tìm kiếm kết hợp | Từ khóa, độ tương đồng ngữ nghĩa và các bộ lọc khác | Tìm tài liệu chính sách liên quan cho một khu vực cụ thể |
Giả sử nhân viên tìm kiếm: “Tôi có thể làm việc tại nhà như thế nào sau khi sinh con?” Một chính sách có thể mang tiêu đề “Nghỉ phép cho cha mẹ và sắp xếp làm việc từ xa”. Nếu cách diễn đạt khác nhau, tìm kiếm bằng từ khóa có thể bỏ sót tài liệu; semantic search dùng embeddings để so sánh các khái niệm liên quan trong câu hỏi và tài liệu.
Semantic search không phải lúc nào cũng tốt hơn. Nó có thể trả về nội dung liên quan ở mức rộng nhưng không phù hợp với câu hỏi cụ thể. Hệ thống thực tế có thể kết hợp độ tương đồng ngữ nghĩa với từ khóa, ngày của tài liệu, nhãn phòng ban, quyền truy cập hoặc bộ lọc khác. Các bằng chứng được cung cấp hỗ trợ việc xem semantic search là một ứng dụng của text embeddings, nhưng không thiết lập quy tắc rằng một phương pháp luôn tốt hơn phương pháp khác.
Embeddings hỗ trợ Retrieval-Augmented Generation như thế nào?
Retrieval-Augmented Generation, hay RAG, là quy trình tìm thông tin liên quan và cung cấp thông tin đó cho generative model trước khi mô hình tạo câu trả lời. Embeddings thường được dùng ở giai đoạn retrieval.
Một trợ lý trả lời về chính sách nội bộ có thể hoạt động như sau:
1. Chuyển các đoạn chính sách thành embedding và lập chỉ mục.
2. Nhân viên đặt câu hỏi bằng ngôn ngữ thông thường.
3. Chuyển câu hỏi thành embedding.
4. Similarity search tìm và lấy về các đoạn chính sách liên quan.
5. Generative AI model nhận các đoạn này làm ngữ cảnh.
6. Mô hình soạn câu trả lời dựa trên tài liệu được truy xuất.
Embeddings giúp tìm các đoạn có khả năng liên quan. Chúng không viết câu trả lời cuối cùng, xác minh mọi chi tiết của chính sách hoặc bảo đảm thông tin vẫn còn hiện hành. Với câu hỏi có hậu quả đáng kể, quy trình vẫn cần hướng dẫn phù hợp, kiểm tra nguồn và sự giám sát của con người.
Text embeddings được dùng trong các pipeline Retrieval-Augmented Generation vì chúng giúp so sánh câu hỏi với tài liệu hoặc đoạn văn có cách diễn đạt khác nhau. (Lightly, “Embeddings in Machine Learning”)
Những loại dữ liệu nào có thể trở thành embeddings?
Tùy vào mô hình và cách xử lý dữ liệu, embeddings có thể biểu diễn văn bản, hình ảnh, âm thanh và những đối tượng có cấu trúc khác như các nút trong đồ thị. Nhờ đó, hệ thống có thể so sánh các đối tượng dưới dạng số. (Cloudflare Learning Center; Lightly, “Embeddings in Machine Learning”)
Một số ví dụ:
- Văn bản: Tìm một đoạn liên quan trong sổ tay nhân viên.
- Hình ảnh: Ghép một bức ảnh sản phẩm với những đối tượng liên quan về hình ảnh hoặc mô tả.
- Âm thanh: Tìm bản ghi hoặc nội dung đào tạo liên quan khi âm thanh đã được xử lý bằng mô hình phù hợp.
- Tài liệu kinh doanh: Nhóm hợp đồng, phiếu hỗ trợ hoặc báo cáo theo chủ đề.
- Dữ liệu có cấu trúc khác: Biểu diễn các mối quan hệ trong dữ liệu như các nút đồ thị, tùy vào mô hình và ứng dụng.
Khi hệ thống xử lý nhiều loại dữ liệu, thuật ngữ multimodal embeddings có thể được sử dụng. Khả năng cụ thể phụ thuộc vào embedding model. Không nên mặc định rằng text embedding model có thể so sánh hình ảnh hoặc âm thanh nếu mô hình chưa được thiết kế và kiểm thử cho mục đích đó.
Embeddings có thể giúp hệ thống AI làm gì?
Embeddings hữu ích khi hệ thống cần tìm đối tượng liên quan, so sánh nội dung, sắp xếp một tập hợp hoặc cung cấp thông tin cho một hệ thống AI khác.
Các ứng dụng phổ biến gồm:
- Semantic search: Tìm tài liệu liên quan đến câu hỏi dù cách diễn đạt khác nhau.
- Text similarity: So sánh phiếu hỗ trợ, nhận xét của khách hàng hoặc tài liệu nháp.
- Document clustering: Nhóm một tập hợp lớn các tệp theo những chủ đề lặp lại.
- Recommendations: Xác định những đối tượng liên quan đến hoạt động trước đây của người dùng hoặc đối tượng họ đã chọn, khi hệ thống xung quanh được thiết kế cho mục đích đó.
- Retrieval cho RAG: Tìm các đoạn văn có thể cung cấp cho generative model làm ngữ cảnh hỗ trợ.
- Tổ chức nội dung: Hỗ trợ sắp xếp hoặc duyệt các tập hợp văn bản, hình ảnh, âm thanh hay dữ liệu khác.
Ví dụ, một công ty có thể dùng embeddings để tìm phiếu hỗ trợ trùng lặp, nhóm phản hồi về vấn đề giao hàng, tìm điều khoản trong thư viện hợp đồng và truy xuất tài liệu cho quy trình hỏi đáp nội bộ. Các ứng dụng này đều dựa trên việc so sánh các biểu diễn thay vì đọc thủ công từng đối tượng khi có truy vấn.
Text embeddings gắn với semantic search, chấm điểm độ tương đồng văn bản, document clustering, phân tích cảm xúc và các pipeline retrieval cho RAG. (Lightly, “Embeddings in Machine Learning”)
Embeddings có những giới hạn gì?
Embeddings giúp hệ thống AI so sánh các mẫu hình, nhưng độ tương đồng không đồng nghĩa với sự thật, sự hiểu biết đầy đủ hoặc mức độ phù hợp để ra quyết định.
Các giới hạn chính gồm:
1. Độ tương đồng không chứng minh tính chính xác. Tài liệu được truy xuất có thể liên quan chặt chẽ đến câu hỏi nhưng vẫn chứa thông tin lỗi thời hoặc không đúng.
2. Độ tương đồng không chứng minh sự phù hợp với đúng tình huống. Hai đối tượng có thể cùng nói về một chủ đề nhưng áp dụng cho sản phẩm, địa điểm, phòng ban hoặc thời điểm khác nhau.
3. Các chi tiết quan trọng có thể bị bỏ sót. Một đoạn văn ngắn có thể trông tương đồng nhưng không chứa điều kiện làm thay đổi câu trả lời.
4. Mô hình phản ánh các mẫu hình đã học. Biểu diễn phụ thuộc vào mô hình và dữ liệu dùng để tạo ra nó.
5. Kết quả gần nhất không phải là sự hiểu biết của con người. Hệ thống so sánh các mẫu hình số đã học; nó không trải nghiệm tình huống và không chịu trách nhiệm cho quyết định.
Ví dụ, khi tìm tài liệu có đề cập đến “chấm dứt”, hệ thống có thể trả về cả hợp đồng lao động và thỏa thuận thuê bao phần mềm vì cả hai đều nói về việc chấm dứt. Kết quả gần nhất vẫn có thể sai với câu hỏi cụ thể. Bộ lọc metadata, kiểm soát quyền truy cập, kiểm tra ngày tháng, xem xét nguồn hoặc người thẩm định có thể cần thiết để chọn đúng tài liệu.
Những giới hạn này đặc biệt quan trọng trong các quy trình liên quan đến pháp lý, tài chính, y tế, việc làm, an ninh và các lĩnh vực có hậu quả đáng kể. Embeddings có thể thu hẹp phạm vi tìm kiếm, nhưng con người nên kiểm tra nguồn gốc và xác nhận mức độ phù hợp trước khi dựa vào kết quả. Các bằng chứng được cung cấp xác lập vai trò so sánh và retrieval của embeddings; chúng không biến độ tương đồng thành bằng chứng về tính đúng đắn.
Người mới bắt đầu nên nhớ gì về embeddings?
Embedding là biểu diễn bằng số do mô hình Machine Learning tạo ra. Nó chuyển một đối tượng như câu hỏi, tài liệu, hình ảnh hoặc đoạn âm thanh thành một vector để so sánh với các vector khác.
Khi các đối tượng liên quan có biểu diễn tương đối gần nhau, hệ thống có thể dùng similarity search để tìm nội dung phù hợp. Cách này hỗ trợ semantic search, tổ chức tài liệu, hệ thống đề xuất và các quy trình retrieval như RAG.
Mô hình tư duy ngắn gọn là: embedding là bản đồ mà máy có thể đọc, biểu diễn mối quan hệ giữa các đối tượng. Nó giúp hệ thống AI tìm nội dung gần với một đối tượng cho một tác vụ cụ thể, nhưng không bảo đảm nội dung đó đúng, đầy đủ hoặc phù hợp. Khi dùng semantic search hoặc RAG, bước xác minh nguồn vẫn cần được giữ trong quy trình.