Dữ liệu huấn luyện là tập hợp các ví dụ giúp mô hình machine learning học mẫu hình cho một nhiệm vụ cụ thể. Những ví dụ này ảnh hưởng đến khả năng nhận diện, dự đoán và phân loại của mô hình sau đó.
Ví dụ, hệ thống phân loại email có thể học từ các thư cũ được gắn nhãn thanh toán, hỗ trợ kỹ thuật hoặc bán hàng. Thay vì viết quy tắc cho mọi cách diễn đạt, lập trình viên cung cấp ví dụ để hệ thống tự học các mẫu hữu ích.
Tóm tắt cốt lõi (Key Takeaways)
- Dữ liệu huấn luyện là gì: Tập hợp các ví dụ được dùng để huấn luyện một mô hình machine learning.
- Cách hoạt động: Mô hình tìm mối quan hệ trong dữ liệu. Một số ví dụ có sẵn câu trả lời hoặc nhãn; những ví dụ khác giúp mô hình tự tìm nhóm và điểm tương đồng.
- Vì sao quan trọng: Dữ liệu huấn luyện khác với dữ liệu kiểm thử. Nhiều dữ liệu hơn không tự động tốt hơn; độ chính xác, mức độ liên quan, độ bao phủ và khả năng cập nhật cũng ảnh hưởng đến độ tin cậy trong công việc thực tế.
Dữ liệu huấn luyện là gì?
Dữ liệu huấn luyện là các ví dụ được dùng để huấn luyện một thuật toán hoặc mô hình machine learning. Mô hình machine learning là hệ thống máy tính học các mẫu hữu ích từ dữ liệu thay vì chỉ thực hiện những quy tắc được viết sẵn. CloudFactory mô tả dữ liệu huấn luyện là dữ liệu được dùng để huấn luyện một thuật toán hoặc mô hình machine learning.
Ví dụ, dữ liệu của hệ thống sắp xếp email có thể gồm các email cũ và phòng ban đã xử lý từng email. Sau khi xem nhiều ví dụ, mô hình có thể liên hệ các cụm từ như “số hóa đơn”, “hạn thanh toán” hoặc “hoàn tiền” với bộ phận thanh toán.
Mô hình AI tạo đầu ra cho một đầu vào mới bằng cách áp dụng các mẫu đã học. Mô hình có thể đề xuất nơi chuyển một email mới, nhưng điều đó không có nghĩa là nó hiểu vấn đề như một chuyên viên hỗ trợ. Nó nhận diện các mẫu từng hữu ích rồi áp dụng chúng vào trường hợp mới.
Dữ liệu huấn luyện giúp mô hình học như thế nào?
Dữ liệu huấn luyện giúp mô hình học bằng cách cung cấp các ví dụ để nhận diện mối quan hệ giữa đầu vào và đầu ra. Quy trình cơ bản gồm các bước sau:
1. Bắt đầu từ một nhiệm vụ. Xác định hệ thống cần làm gì, chẳng hạn chuyển yêu cầu của khách hàng đến đúng phòng ban.
2. Cung cấp các ví dụ liên quan. Đưa vào các tin nhắn cũ và, khi có thể, danh mục đúng của từng tin nhắn.
3. Học các mẫu lặp lại. Trong quá trình huấn luyện, mô hình điều chỉnh cách xử lý bên trong để liên kết các mẫu trong tin nhắn với đầu ra phù hợp hơn.
4. Áp dụng cho đầu vào mới. Với một tin nhắn mới, mô hình dùng những gì đã học để đề xuất danh mục hoặc đưa ra dự đoán.
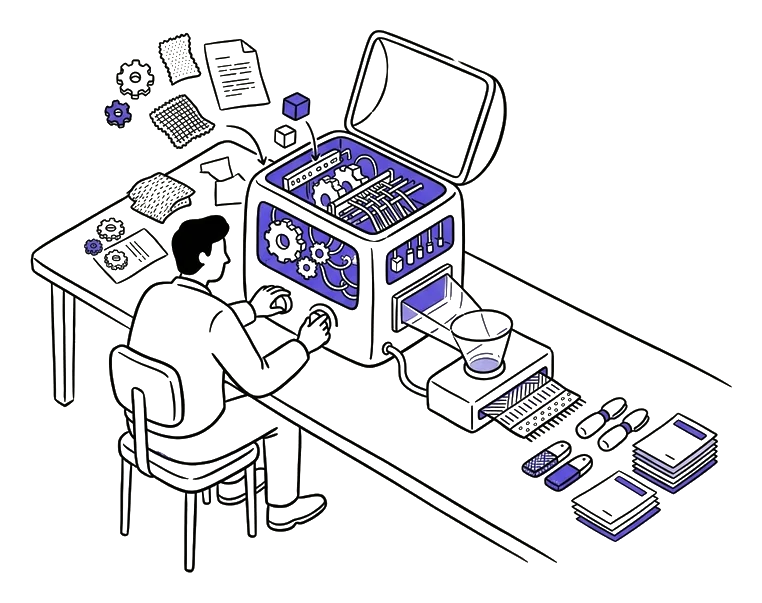
Chẳng hạn, các tin nhắn chứa cụm “không thể đăng nhập” thường có thể được liên kết với bộ phận hỗ trợ kỹ thuật. Vì vậy, tin nhắn “tài khoản không cho tôi đăng nhập” có thể được chuyển đến bộ phận này. Tuy nhiên, cách diễn đạt bất thường, thông tin chưa đầy đủ hoặc chủ đề không xuất hiện trong dữ liệu huấn luyện vẫn có thể khiến mô hình mắc lỗi.
Đây là cách mô hình học từ ví dụ: nhận diện mẫu hình, đưa ra dự đoán hoặc thực hiện một nhiệm vụ cụ thể. Quy trình này không bảo đảm mô hình hiểu mọi tình huống. Unidata cũng giải thích rằng dữ liệu huấn luyện là tập dữ liệu dùng để dạy mô hình các mẫu hình và mối quan hệ liên quan đến nhiệm vụ.
Có thể dùng gì làm dữ liệu huấn luyện?
Dữ liệu huấn luyện có thể là văn bản, số liệu, hình ảnh, âm thanh hoặc video, miễn phù hợp với nhiệm vụ. Dữ liệu cũng có thể ở dạng bảng tính, PDF, trang HTML hoặc tệp JSON. CloudFactory lưu ý rằng nội dung và định dạng tệp thay đổi tùy theo trường hợp sử dụng machine learning.
Một số ví dụ phổ biến:
- Văn bản: Tin nhắn hỗ trợ khách hàng dùng để phân loại yêu cầu theo chủ đề.
- Hình ảnh: Ảnh sản phẩm được đánh dấu là lỗi hoặc đạt yêu cầu để kiểm tra chất lượng.
- Số liệu và hồ sơ: Giao dịch trước đây dùng để nhận diện các mẫu hình cần xem xét.
- Âm thanh: Bản ghi cuộc gọi dùng trong hệ thống nhận diện các cụm từ được nói.
- Video: Đoạn phim dùng cho nhiệm vụ nhận diện sự kiện hoặc vật thể theo thời gian.
Tài liệu nguồn không tự động trở thành dữ liệu huấn luyện hữu ích. Một thư mục PDF có thể chứa thông tin liên quan, nhưng nhóm phụ trách vẫn cần chọn đúng tài liệu, sắp xếp, loại bỏ bản trùng lặp hoặc thêm nhãn để dữ liệu phù hợp với nhiệm vụ.
Dữ liệu huấn luyện có nhãn và không nhãn
Dữ liệu có nhãn chứa ví dụ cùng câu trả lời hoặc danh mục đã xác định; dữ liệu không nhãn chỉ chứa các ví dụ mà chưa có sẵn câu trả lời.
| Loại dữ liệu | Nội dung | Cách dùng điển hình | Ví dụ trong công việc |
|---|---|---|---|
| Dữ liệu có nhãn | Đầu vào cùng danh mục hoặc câu trả lời đã biết | Dạy mô hình một nhiệm vụ được xác định rõ | Tin nhắn hỗ trợ được gắn nhãn “thanh toán”, “bán hàng” hoặc “kỹ thuật” |
| Dữ liệu không nhãn | Đầu vào không có câu trả lời được cung cấp | Tìm các nhóm, điểm tương đồng hoặc cấu trúc | Một tập hợp lớn tin nhắn khách hàng chưa được gắn nhãn, được nhóm theo mức độ tương đồng |
Với dữ liệu có nhãn, mô hình so sánh đầu vào với đầu ra mong đợi trong quá trình huấn luyện. Cách tiếp cận này gọi là học có giám sát (supervised learning). Ví dụ, bảng tính có thể ghép từng tin nhắn khách hàng với nhóm đã xử lý tin nhắn đó.
Với dữ liệu không nhãn, hệ thống tìm mẫu hình mà không được cung cấp danh mục đúng cho từng mục. Đây là học không giám sát (unsupervised learning). Hệ thống có thể nhận diện các nhóm tin nhắn tương tự để nhóm phụ trách kiểm tra và đặt tên sau đó.
Cách tiếp cận phù hợp phụ thuộc vào mục tiêu. Chuyển email đến các phòng ban đã biết thường cần ví dụ có nhãn; phát hiện chủ đề lặp lại trong phản hồi chưa phân loại có thể dùng dữ liệu không nhãn. CloudFactory phân biệt học có giám sát với dữ liệu có nhãn và học không giám sát với dữ liệu không nhãn.
Dữ liệu huấn luyện, dữ liệu validation và dữ liệu test khác nhau thế nào?
Ba tập dữ liệu này phục vụ các mục đích khác nhau: dữ liệu huấn luyện để mô hình học, validation để định hướng phát triển và test để đánh giá cuối cùng.
| Tập dữ liệu | Mục đích chính | Thời điểm sử dụng | Quy tắc chính |
|---|---|---|---|
| Dữ liệu huấn luyện | Dạy mô hình các mẫu hình | Trong quá trình huấn luyện | Mô hình học trực tiếp từ dữ liệu này |
| Dữ liệu validation | So sánh các lựa chọn phát triển và điều chỉnh thiết lập | Trong quá trình phát triển | Giúp định hướng cải thiện nhưng không trở thành thước đo cuối cùng |
| Dữ liệu test | Đánh giá hiệu suất trên các ví dụ chưa từng thấy | Sau quá trình phát triển | Giữ riêng cho đến khi đánh giá cuối cùng |
Dữ liệu huấn luyện giống tài liệu thực hành. Dữ liệu validation giúp nhóm phụ trách so sánh các lựa chọn khi mô hình vẫn đang được cải thiện. Dữ liệu test được giữ lại để đánh giá hiệu suất trên các ví dụ mô hình chưa dùng để học hoặc điều chỉnh.
Với mô hình phân loại email, nhóm có thể dùng một tập email lịch sử để huấn luyện, một tập khác để so sánh các lựa chọn phát triển và một tập riêng để đánh giá cuối cùng. Nếu liên tục dùng tập test để ra quyết định trong quá trình phát triển, kết quả có thể cao hơn hiệu suất trên các tin nhắn thực sự mới.
Trong thực hành machine learning, dữ liệu huấn luyện hỗ trợ việc học, validation hỗ trợ lựa chọn và điều chỉnh mô hình, còn test hỗ trợ đánh giá cuối cùng trên dữ liệu chưa từng thấy. Unidata
Vì sao chất lượng dữ liệu huấn luyện quan trọng?
Chất lượng dữ liệu huấn luyện quan trọng vì mô hình chỉ có thể học từ những ví dụ được cung cấp. Mô hình phức tạp không thể bù đắp đáng tin cậy cho dữ liệu thiếu chính xác, không liên quan, không nhất quán hoặc bỏ sót các trường hợp quan trọng.
Khi xem xét một tập dữ liệu, nhóm phụ trách cần hỏi:
1. Dữ liệu có chính xác không? Hồ sơ và nhãn sai sẽ dạy mô hình mối quan hệ sai.
2. Dữ liệu có liên quan không? Ví dụ phải phù hợp với nhiệm vụ mô hình sẽ thực hiện.
3. Dữ liệu có bao phủ các trường hợp thực tế không? Dữ liệu nên thể hiện sự đa dạng về sản phẩm, cách viết, nhóm khách hàng hoặc điều kiện mà mô hình cần xử lý.
4. Dữ liệu có nhất quán không? Các trường hợp tương tự nên được gắn nhãn và ghi nhận theo cách tương thích.
5. Nhãn có đáng tin cậy không? Nếu mỗi người áp dụng danh mục khác nhau, mô hình sẽ nhận các tín hiệu mâu thuẫn.
Ví dụ, mô hình xử lý yêu cầu hỗ trợ được huấn luyện chủ yếu bằng tin nhắn về một dòng sản phẩm có thể hoạt động tốt với dòng đó nhưng kém hiệu quả khi gặp sản phẩm mới, biến thể ngôn ngữ theo vùng hoặc loại vấn đề khác. Đây là vấn đề về độ bao phủ: dữ liệu không đại diện đủ cho tình huống thực tế.
Dữ liệu kém chất lượng hoặc không đại diện có thể góp phần gây hiệu suất yếu, kết quả kém trên trường hợp mới, kết quả bị lệch hoặc dự đoán thiếu hợp lý. Chất lượng dữ liệu không phải yếu tố duy nhất, nhưng là một yếu tố lớn. Unidata cảnh báo rằng dữ liệu kém chất lượng có thể dẫn đến hiệu suất thấp, thiên lệch, khả năng khái quát hóa kém và các dự đoán vô nghĩa.
Quy trình dữ liệu huấn luyện đơn giản
Quy trình dữ liệu huấn luyện gồm xác định nhiệm vụ, chuẩn bị ví dụ, huấn luyện, đánh giá và xem xét lỗi.
1. Xác định nhiệm vụ. Nêu rõ kết quả cần đạt, chẳng hạn chuyển email đến bộ phận thanh toán, hỗ trợ kỹ thuật hoặc bán hàng.
2. Thu thập các ví dụ liên quan. Tập hợp email cũ phản ánh các loại yêu cầu hệ thống cần xử lý.
3. Làm sạch và sắp xếp các ví dụ. Loại bỏ bản trùng lặp rõ ràng, sửa lỗi khi có thể và đưa hồ sơ về dạng phù hợp.
4. Thêm nhãn khi cần. Đánh dấu phòng ban nên nhận từng email.
5. Tách dữ liệu phát triển và đánh giá. Giữ lại một số ví dụ cho validation và kiểm thử cuối cùng.
6. Huấn luyện và đánh giá mô hình. Dùng dữ liệu huấn luyện để mô hình học mẫu hình, sau đó đánh giá bằng các ví dụ chưa dùng để huấn luyện.
7. Xem xét các lỗi. Kiểm tra email bị chuyển sai để xác định vấn đề nằm ở ví dụ bị thiếu, nhãn chưa rõ ràng hay định nghĩa nhiệm vụ.
Dữ liệu huấn luyện không chỉ là một tệp giao cho hệ thống AI. Đó là tập hợp các ví dụ được lựa chọn và chuẩn bị cho một mục đích cụ thể. Các quyết định trước và sau huấn luyện đều ảnh hưởng đến mức độ hữu ích của hệ thống.
Mô hình cần bao nhiêu dữ liệu huấn luyện?
Không có một lượng dữ liệu chung cho mọi mô hình machine learning. Mức phù hợp phụ thuộc vào nhiệm vụ, độ đa dạng của đầu vào thực tế, chất lượng ví dụ, cách tiếp cận mô hình và mức độ đáng tin cậy cần đạt.
Một nhiệm vụ nội bộ có phạm vi hẹp, chẳng hạn phân loại biểu mẫu chuẩn hóa, cần tập dữ liệu rất khác nhiệm vụ có nhiều ngôn ngữ, sản phẩm, cách viết hoặc điều kiện hình ảnh. Thêm ví dụ có thể hữu ích nếu chúng bổ sung sự đa dạng phù hợp. Ngược lại, dữ liệu trùng lặp, thiếu chính xác, không liên quan hoặc được gắn nhãn kém không tự động cải thiện mô hình.
Câu hỏi thực tế không phải “Bao nhiêu là đủ?” mà là “Dữ liệu hiện có có đại diện cho những trường hợp hệ thống phải xử lý không, và đánh giá trên các ví dụ riêng biệt có cho thấy kết quả chấp nhận được không?” Các bằng chứng được cung cấp không xác lập quy tắc chung về quy mô tập dữ liệu. Vì vậy, con số cần gắn với từng nhiệm vụ và dựa trên kết quả đánh giá.
Vì sao dữ liệu huấn luyện có thể cần thay đổi theo thời gian?
Dữ liệu huấn luyện có thể dần không còn đại diện khi thực tế thay đổi. Sản phẩm thay đổi, khách hàng dùng thuật ngữ mới, phương thức gian lận chuyển biến, quy định được cập nhật và quy trình kinh doanh phát triển.
Ví dụ, mô hình phân loại dịch vụ khách hàng được huấn luyện trước khi ra mắt sản phẩm mới có thể không nhận diện tên sản phẩm hoặc các vấn đề thường gặp của sản phẩm đó. Dữ liệu cũ không nhất thiết sai; chúng có thể chỉ không còn bao phủ đầy đủ công việc hiện tại.
Tổ chức có thể cần xem xét các ví dụ mới, cập nhật tập dữ liệu, huấn luyện lại mô hình hoặc đánh giá lại nhiệm vụ ban đầu. CloudFactory lưu ý rằng dữ liệu huấn luyện có thể cần được cập nhật và mô hình có thể cần huấn luyện lại khi điều kiện thực tế thay đổi.
Ý nghĩa thực tế của dữ liệu huấn luyện
Dữ liệu huấn luyện cung cấp ví dụ để mô hình học mẫu hình, nhưng không bảo đảm hệ thống AI xử lý đúng mọi trường hợp mới. Khi đánh giá một tính năng AI, hãy kiểm tra:
1. Mô hình được huấn luyện để thực hiện nhiệm vụ gì? Mô hình cho một loại phân loại có thể không phù hợp với loại khác.
2. Các ví dụ có phù hợp với tình huống thực tế không? Cần cân nhắc sản phẩm, nhóm khách hàng, ngôn ngữ, loại tài liệu và điều kiện hiện tại.
3. Hiệu suất được đánh giá như thế nào? Đánh giá đáng tin cậy sử dụng dữ liệu được giữ riêng với dữ liệu huấn luyện.
4. Điều gì đã thay đổi? Quy trình, ngôn ngữ hoặc quy định mới có thể khiến dữ liệu ban đầu không còn đầy đủ.
Mô hình tư duy hữu ích là: dữ liệu huấn luyện cung cấp cho mô hình machine learning các ví dụ để học mẫu hình; nhãn xác định điều mô hình được dạy nhận diện; dữ liệu test nên được giữ riêng; còn chất lượng dữ liệu ảnh hưởng đến độ tin cậy trong thực tế. Để xây dựng nền tảng này, hãy xem mô hình AI là gì và cách kiểm chứng câu trả lời của AI.